
 Rafael Nazar
A Meta apresentou nesta terça-feira (1º) o Muse Voice Transcribe, seu primeiro modelo de inteligência artificial voltado à percepção de áudio em tempo real. A tecnologia transcreve conversas enquanto elas acontecem, identifica quem está falando e consegue lidar com mais de 20 pessoas simultaneamente.
Desenvolvido pelo Meta Superintelligence Labs (MSL), o modelo também trabalha com diferentes idiomas em uma mesma conversa. Segundo a empresa, o sistema foi treinado com mais de 70 idiomas, dos quais 25 foram amplamente validados para o lançamento.
Uma das funções do Muse Voice Transcribe é o chamado code-switching, quando uma pessoa alterna entre idiomas durante uma conversa. A IA consegue reconhecer a mudança mesmo no meio de uma frase.
Em uma demonstração divulgada pela Meta, oito pessoas conversam simultaneamente, e o sistema identifica cada participante e associa corretamente suas falas. A tecnologia também lida com interrupções, sobreposição de vozes e diferentes sotaques.
O modelo reúne três funções principais: reconhecimento automático de fala em fluxo contínuo, identificação dos participantes da conversa, conhecida como speaker diarization, e identificação dos momentos em que uma fala começa ou termina.
O Muse Voice Transcribe processa o áudio em blocos de 80 milissegundos. A cada novo trecho, o sistema decide se deve continuar ouvindo ou começar a produzir o texto. A Meta chama esse mecanismo de “atraso adaptativo”.
Na prática, a IA pode esperar um pouco mais quando encontra uma palavra difícil e gerar a transcrição mais rapidamente ao identificar uma palavra simples. A estratégia busca equilibrar velocidade e precisão: quanto mais tempo o modelo espera antes de transcrever, maior tende a ser a precisão, mas também aumenta o atraso na resposta.
O sistema ainda pode usar informações sobre o idioma, palavras-chave e contexto para melhorar a precisão das transcrições. Segundo a Meta, o Muse Voice Transcribe alcançou a primeira posição nos rankings da Artificial Analysis para reconhecimento de fala em streaming e em benchmarks públicos de identificação de participantes. A classificação considera os resultados disponíveis em 1º de setembro de 2026.
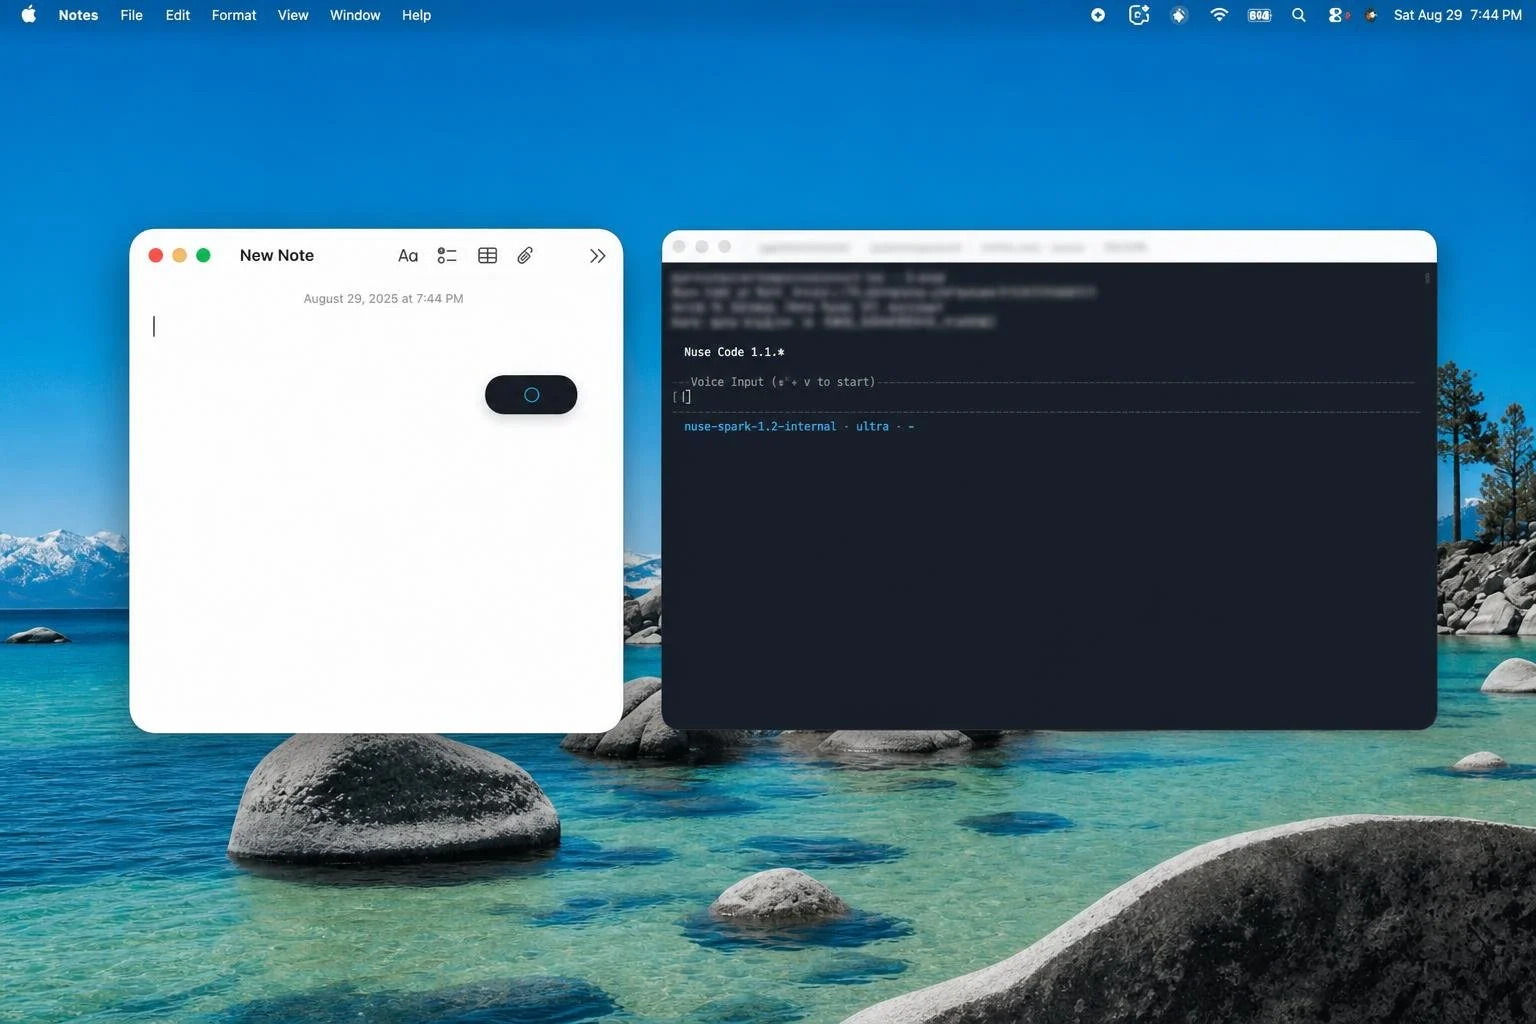
O novo modelo já é utilizado em recursos de ditado do aplicativo Meta AI para Mac. Como o aplicativo oferece recursos de voz para outros serviços, o Muse Voice Transcribe também pode ser usado em diferentes aplicações.
A tecnologia está disponível para desenvolvedores por meio do Muse Code e da API de modelos da Meta. O acesso custa US$ 3, cerca de R$ 15,50, por mil minutos de áudio. A empresa também disponibilizou uma demonstração em sua página de pesquisa, permitindo testar a transcrição de áudio em tempo real.
O lançamento ocorreu menos de uma semana após a apresentação do Gemini 3.5 Transcribe, do Google, que também aposta em recursos avançados de reconhecimento de áudio. A diferença, segundo a Meta, é que o Muse Voice Transcribe combina transcrição, identificação de múltiplos participantes e processamento multilíngue em tempo real.



