
 Rafael Nazar
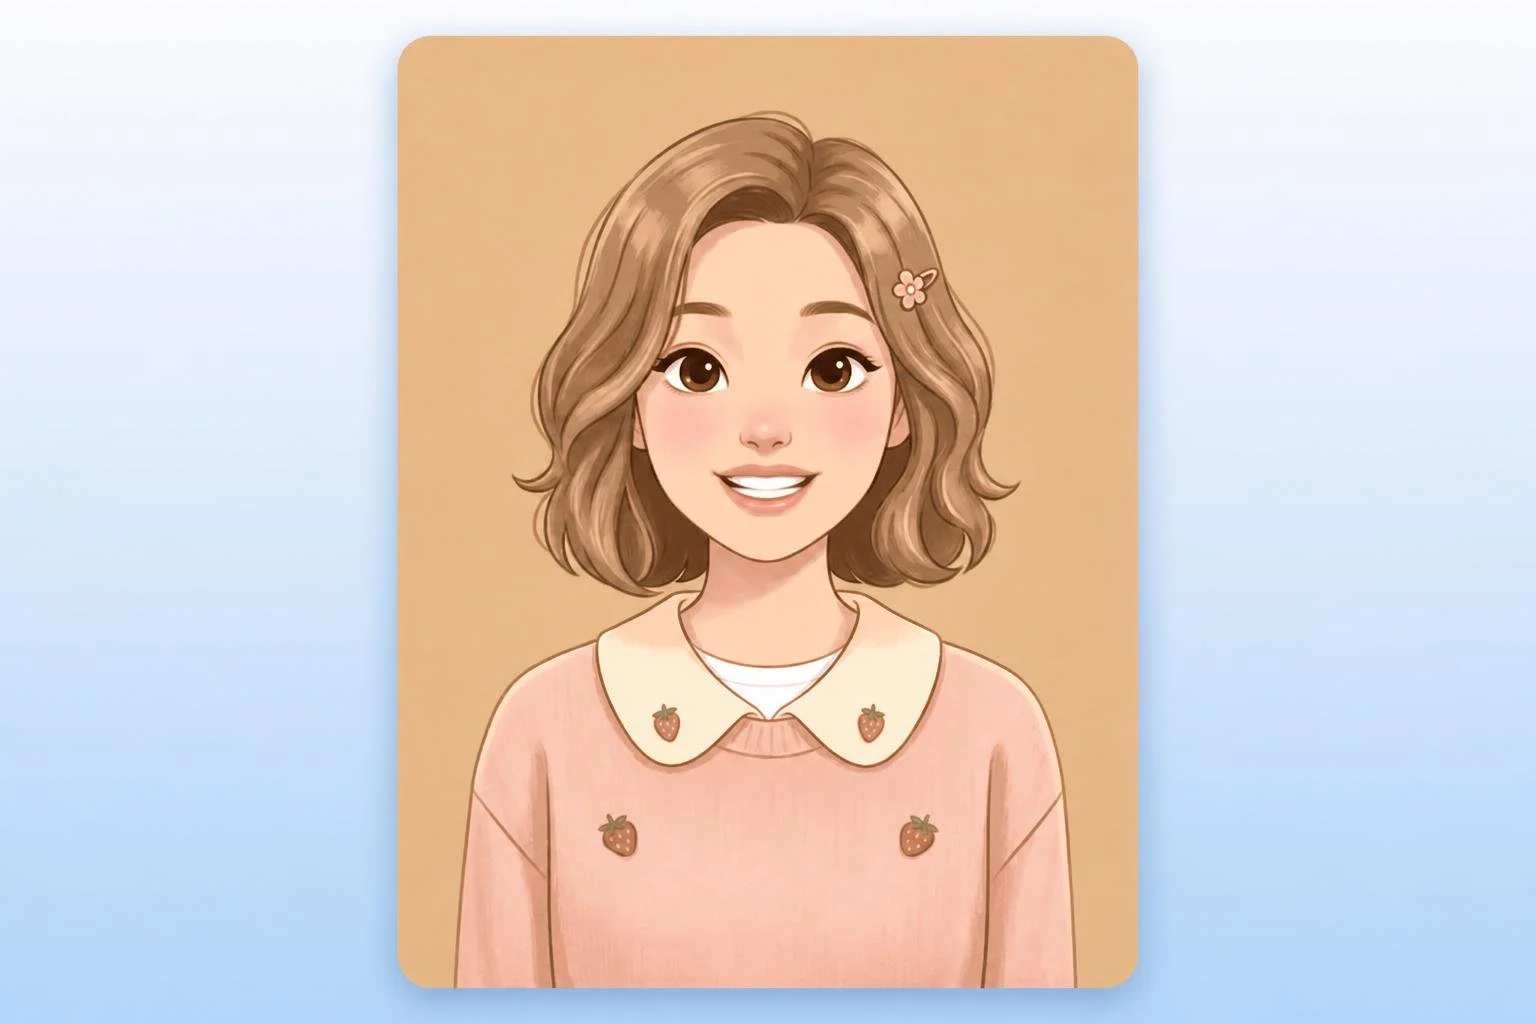
O Google apresentou nesta quinta-feira (24) o Gemini 3.8 Live com o recurso Live Avatar, que adiciona uma persona animada à tela para conversar com o usuário em tempo quase real. A novidade está disponível no Gemini Enterprise.
O avatar sincroniza os movimentos da boca com a fala, exibe diferentes expressões faciais e mantém diálogos de forma mais natural. A tecnologia combina geração de vídeo de baixa latência com os recursos de conversação ao vivo do Gemini, permitindo que a inteligência artificial responda por voz e também tenha uma presença visual durante a interação.
Segundo o Google, o Live Avatar foi desenvolvido para aplicações empresariais, como atendimento ao cliente e experiências interativas. O sistema consegue processar informações visuais e de áudio simultaneamente durante as conversas.
Um dos destaques é a possibilidade de alternar entre 97 idiomas durante o diálogo. De acordo com a empresa, o avatar adapta a sincronização labial e as expressões sem perda de fidelidade visual ou introdução de “desvio visual”. Em uma demonstração divulgada pelo Google, o mesmo avatar conversa em inglês e japonês, acompanhando a fala com os movimentos da boca nos dois idiomas.
O Live Avatar também pode exibir informações na tela enquanto conversa. Além disso, a inteligência artificial consegue executar ferramentas em segundo plano, como buscar dados ou realizar determinadas tarefas sem interromper o diálogo.
O Google cita como exemplo o atendimento a um hóspede durante o check-in de um hotel. Nesse caso, o avatar pode acionar ferramentas necessárias enquanto mantém a conversa ativa com o usuário.
As organizações poderão escolher entre uma biblioteca de avatares prontos ou criar personagens personalizados. Para isso, os desenvolvedores podem usar uma imagem de referência e gerar um avatar animado que preserve características visuais, a identidade de um personagem ou elementos de uma marca. Atualmente, a criação de avatares personalizados está disponível apenas por meio de uma lista de empresas autorizadas.
O Google afirma ainda que todo conteúdo gerado por seus produtos de inteligência artificial recebe a marca d’água invisível SynthID. Incorporada ao áudio e ao vídeo, a tecnologia ajuda a identificar conteúdos criados por IA.
Enquanto apresenta essa nova forma de interação com o Gemini, o Google também prepara o próximo avanço de seus modelos de inteligência artificial. O Gemini 4 está em fase de refinamento e deve ser lançado “muito antes” do fim de 2026, segundo Koray Kavukcuoglu, chefe do Google DeepMind.
Em entrevista ao The Information, Kavukcuoglu afirmou que a intenção da empresa é disponibilizar uma primeira versão do modelo após o treinamento final “o mais rápido possível”, porque os resultados obtidos até agora são animadores. “Nossa intenção é, tipo — assim que possível — lançar uma versão inicial pós-treinamento porque vemos os resultados e estamos animados”, declarou o executivo.
Kavukcuoglu também disse que o Google pretende manter um ritmo acelerado de lançamento de novas versões. Relatos publicados nesta quinta-feira (24) indicam que o Gemini 4 já entrou na etapa de pós-treinamento, período em que o comportamento do modelo é refinado antes da disponibilização. O processo inclui testes internos e a implementação de mecanismos de segurança.
O executivo assumiu a liderança do Google DeepMind após uma mudança na estrutura da divisão. Ele já havia comentado publicamente, em setembro, o desenvolvimento do Gemini 4 e o andamento do treinamento do novo modelo.
Segundo Kavukcuoglu, o objetivo do Google é continuar na fronteira do desenvolvimento de inteligência artificial. Questionado sobre a possibilidade de a empresa ficar atrás dos concorrentes, ele respondeu ao The Information que, em sua avaliação, é uma “certeza” que o Google estará sempre na fronteira.
O avanço do Gemini 4 ocorre enquanto o Google amplia a família Gemini 3.8. Apresentado em setembro, o Gemini 3.8 Live é voltado para diálogos em tempo quase real, com capacidade de processar informações visuais, alternar entre 97 idiomas e executar ferramentas em segundo plano durante as conversas. Com o Live Avatar, o modelo passa a contar também com uma camada visual, falando por meio de uma persona animada com expressões faciais e sincronização labial em tempo real.



