 Rafael Nazar
A inteligência artificial generativa já faz parte da rotina em celulares, buscadores e redações. Apesar disso, ainda é difícil explicar, passo a passo, por que um modelo produz determinada resposta. É justamente essa questão que pesquisadores da área de interpretabilidade tentam esclarecer.
Estudos recentes sobre o funcionamento interno dos modelos de linguagem indicam que esses sistemas podem fazer mais do que repetir padrões estatísticos. As pesquisas sugerem a existência de estruturas internas capazes de organizar informações de maneira mais consistente do que se imaginava.
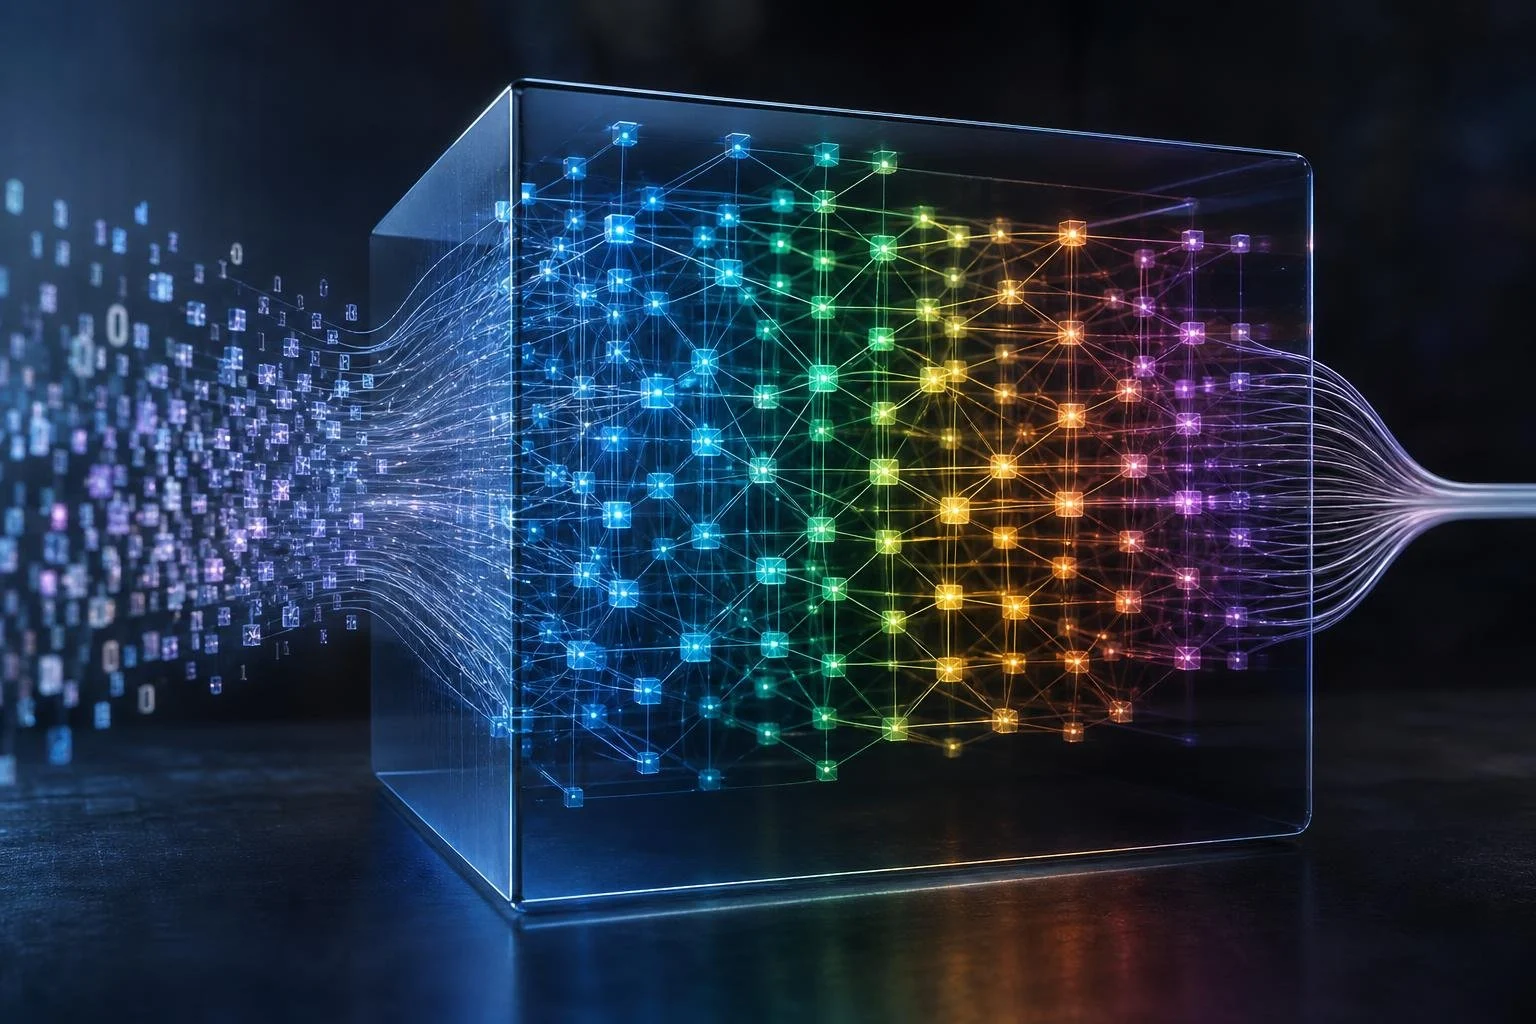
Durante o processamento de textos, os modelos ativam conjuntos específicos de neurônios artificiais. Pesquisadores conseguiram isolar parte desses conjuntos e relacioná-los a conceitos reconhecíveis por humanos, como lugares, pessoas e comportamentos indesejados.
Um dos trabalhos mais citados nessa área relata a extração de milhões de “características” interpretáveis em um modelo comercial de grande porte. Em outra frente, cientistas treinaram modelos para tarefas específicas, como jogos de tabuleiro, e encontraram indícios de uma representação interna do estado da partida, semelhante a um mapa mental rudimentar.
Se esses resultados forem confirmados em modelos de maior escala, a descoberta pode modificar a forma como a inteligência artificial generativa é compreendida. A hipótese enfraquece a visão de que esses sistemas seriam apenas “papagaios estatísticos” e reforça a possibilidade de que exista algum tipo de organização do conhecimento em seu interior.
Na prática, compreender esses mecanismos pode ajudar a reduzir alucinações, ao identificar circuitos associados a respostas inventadas; auditar sistemas usados em áreas como saúde, crédito e segurança pública; corrigir comportamentos problemáticos sem a necessidade de treinar novamente todo o modelo; e atender a exigências de transparência previstas em legislações, como a lei europeia de inteligência artificial.
Atualmente, grande parte do controle é feita externamente, por meio de filtros, instruções e testes de estresse. A possibilidade de intervir diretamente nos mecanismos internos dos modelos representaria uma mudança significativa.
Os estudos, no entanto, não demonstram que a IA compreende o mundo como uma pessoa. Uma representação interna não equivale à consciência nem ao raciocínio humano. Além disso, as técnicas de interpretabilidade explicam apenas uma parte das ativações dos modelos, enquanto o restante continua opaco.
Os experimentos mais claros também costumam envolver modelos menores ou tarefas controladas. Ainda não há garantia de que os resultados se repitam nos sistemas de fronteira, que podem ter centenas de bilhões de parâmetros. Outra questão em aberto é quanto desse conhecimento poderá ser transformado em uma ferramenta de controle realmente útil.
O mapeamento de características internas exige alto poder computacional e nem sempre resulta em controle efetivo sobre as respostas produzidas pelo modelo.
Pesquisadores também fazem um alerta metodológico. Muitos dos estudos mais comentados sobre inteligência artificial generativa são divulgados inicialmente em repositórios de preprints, antes da conclusão da revisão por pares. Parte deles é produzida pelas próprias empresas que desenvolvem os modelos, o que não invalida os resultados, mas reforça a necessidade de replicação independente.
O entendimento possível até agora é que a IA generativa parece ser mais estruturada internamente do que a ideia de um “papagaio estatístico” indicava, mas continua menos compreensível do que o discurso de marketing sugere. Novas pesquisas devem ajudar a reduzir essa distância, enquanto o ceticismo permanece uma postura recomendável.