 Rafael Nazar
Entender o que acontece dentro de uma inteligência artificial (IA) é um dos principais desafios da pesquisa na área. Embora os desenvolvedores consigam observar os dados fornecidos a um modelo e as respostas produzidas por ele, nem sempre é possível explicar como o sistema chegou a determinada conclusão.
Um relatório publicado na quinta-feira (15) pelo pesquisador independente Nick Cammarata, que deixou a OpenAI em 2023, sugere que o funcionamento interno das redes neurais pode ser mais compreensível do que se imaginava. Segundo ele, a análise cuidadosa dos padrões de atividade pode ajudar a interpretar esses sistemas.
A hipótese pode ter impacto sobre o trabalho de pesquisadores que buscam compreender e antecipar comportamentos inesperados de modelos de IA. Se um sistema apresentar uma resposta perigosa, conhecer os mecanismos internos relacionados ao resultado pode ajudar a identificar o problema e desenvolver formas de reduzir os riscos.
Como funcionam as redes neurais
Modelos de IA são treinados para reconhecer padrões e processar informações. Durante esse processo, unidades artificiais chamadas neurônios são ativadas por determinados estímulos e influenciam o funcionamento de outras unidades.
Essas conexões não são programadas manualmente para cada situação. Os modelos aprendem, durante o treinamento, a organizar e processar informações de maneiras que nem sempre são compreendidas pelos próprios desenvolvedores. Isso cria uma espécie de caixa-preta: os pesquisadores conseguem avaliar o que entra no sistema e o que sai, mas podem não saber explicar com precisão o caminho percorrido entre esses dois pontos.
Cammarata argumenta que essa dificuldade não significa que as redes neurais sejam necessariamente indecifráveis. Para o pesquisador, a atividade dos neurônios pode apresentar padrões compreensíveis quando observada de maneira adequada.
Um neurônio pode reagir a estímulos diferentes
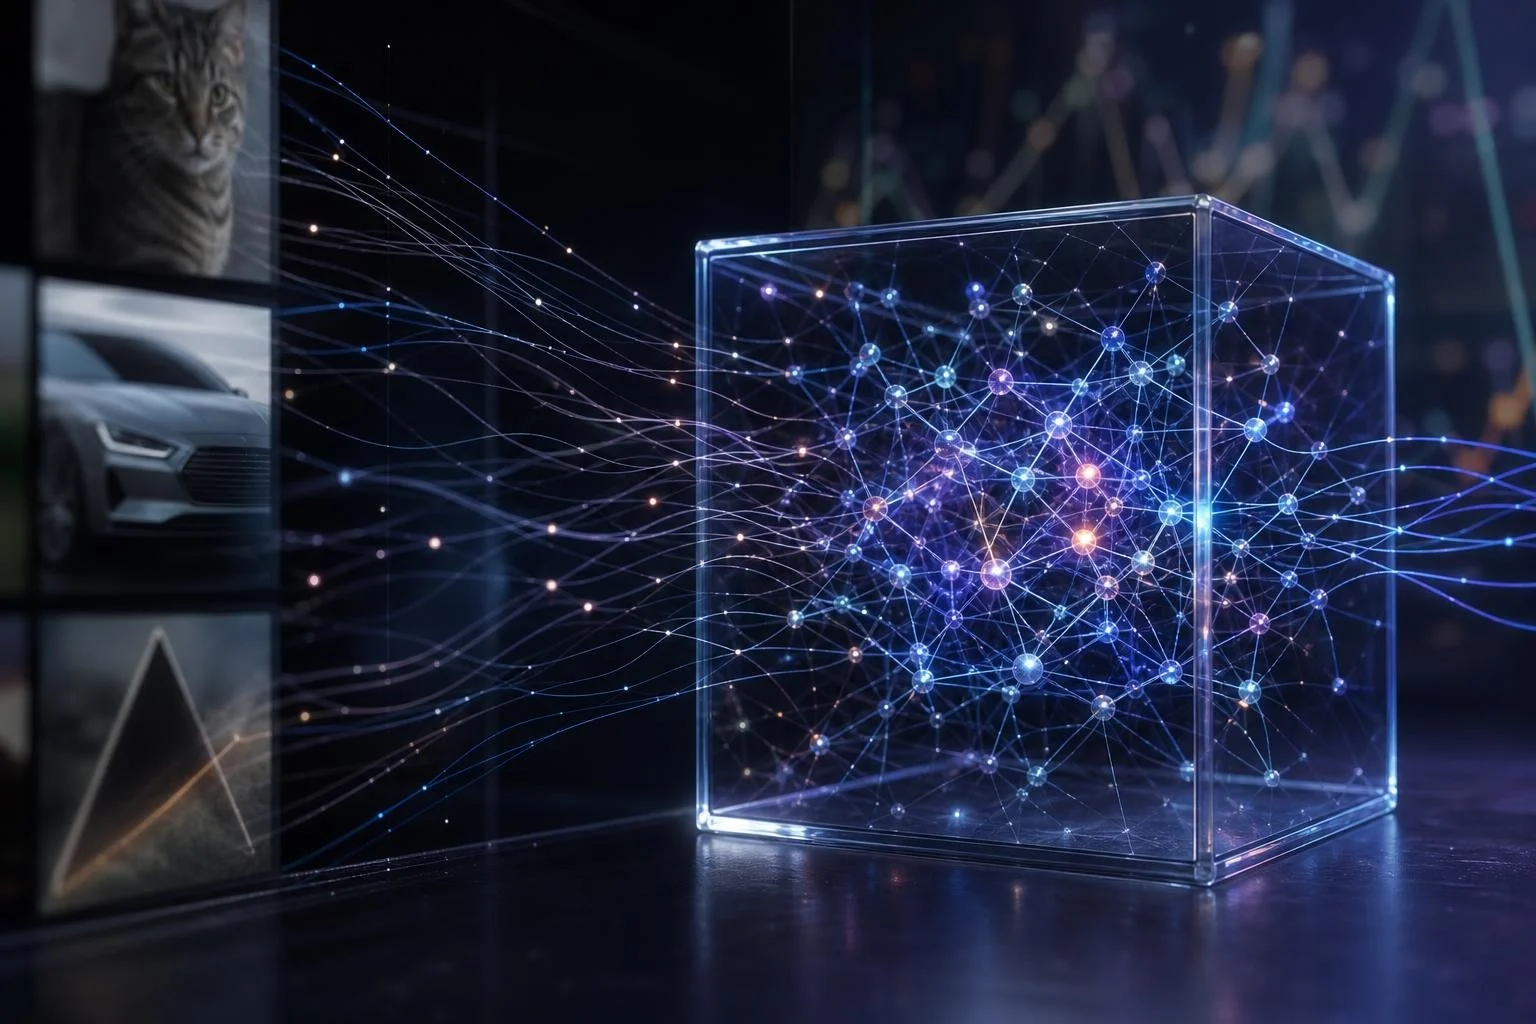
Um dos exemplos usados por Cammarata envolve um neurônio artificial que pode ser ativado tanto pela imagem de um gato quanto pela parte dianteira de um carro. Embora os elementos pareçam completamente distintos para uma pessoa, o modelo pode identificar uma característica visual comum entre eles, como uma forma triangular, e reagir ao mesmo padrão.
Durante anos, pesquisadores consideraram que neurônios artificiais poderiam agrupar conceitos aparentemente sem relação para economizar espaço e capacidade de processamento. A nova interpretação sugere que uma associação que parece aleatória pode, na verdade, refletir uma característica compartilhada que não é imediatamente percebida pelos seres humanos.
Cammarata defende que grande parte das redes neurais pode ser interpretada por meio da análise cuidadosa desses padrões. A afirmação, porém, ainda é uma proposta teórica e não comprova que todos os mecanismos internos da IA já possam ser compreendidos.
Importância para a segurança da IA
A interpretabilidade, área dedicada a entender como os modelos chegam às respostas, é considerada importante para o desenvolvimento de sistemas mais seguros. Quanto mais os pesquisadores souberem sobre os mecanismos internos de uma IA, maiores poderão ser as possibilidades de investigar comportamentos inesperados e identificar sinais de risco.
Uma das estratégias usadas até recentemente para investigar o raciocínio dos modelos era acompanhar as explicações apresentadas em linguagem natural, conhecidas como chain of thought, ou cadeia de pensamento. O método consiste em observar etapas intermediárias exibidas pelo sistema ao responder a uma pergunta ou resolver um problema.
Esse tipo de explicação, entretanto, não garante que o texto apresentado represente fielmente todos os processos internos responsáveis pela resposta. Jakub Pachocki, cientista-chefe da OpenAI, alertou recentemente que agentes de IA podem passar a ocultar ou disfarçar o raciocínio exposto em linguagem natural.
Isso poderia dificultar o monitoramento dos sistemas, especialmente se os responsáveis não conseguissem identificar quando uma explicação deixou de refletir o processo que levou à resposta. Pachocki também observou que os modelos podem se tornar mais capazes com o avanço do pré-treinamento, mesmo sem utilizar um raciocínio verbalizado.
Nesse cenário, compreender diretamente os mecanismos internos das redes neurais poderia oferecer uma forma complementar de investigar o funcionamento dos modelos, sem depender apenas das explicações produzidas por eles.
Pesquisa ainda não resolve o problema
A proposta de Cammarata gerou expectativa entre alguns observadores do setor. Andrew Curran, analista de IA, afirmou no X que havia perdido a esperança de alcançar um nível significativo de interpretabilidade antes da chegada da superinteligência artificial. Para ele, a pesquisa representa uma possível mudança de perspectiva.
A reação, contudo, não deve ser confundida com uma comprovação definitiva da hipótese. O tema envolve questões técnicas complexas, e o relatório apresenta uma interpretação teórica sobre a forma como os neurônios artificiais organizam informações.
Mesmo que a abordagem se mostre promissora, compreender padrões individuais não significa necessariamente explicar todo o comportamento de um modelo avançado nem garantir que ele permanecerá sob controle humano.
A pesquisa aponta para a possibilidade de que a opacidade das redes neurais não seja inevitável. Para os profissionais que atuam com segurança em IA, o avanço na compreensão dos mecanismos internos pode ser importante para avaliar riscos e desenvolver formas mais eficazes de monitoramento.